1. 功能简介 #
Scraping API 是一款面向业务人员和开发团队的可视化网页数据采集工具。它将网页访问、内容清洗、字段识别和数据抽取封装成现成的采集模板,用户无需编写代码,也无需自行处理网页结构、反爬策略或数据格式转换。
只需在页面中选择目标网站和采集模板,填写必要参数并点击“发起请求”,即可直接获得清洗和抽取后的结构化数据。对于常见的商品详情、搜索结果等场景,模板会自动完成页面内容处理,并按照预先定义的输出结构返回结果。
产品的主要优势:
- 零代码使用:通过模板市场、表单和按钮完成采集配置,不需要编写爬虫程序。
- 点击即可获取结果:选择模板并填写参数后即可发起采集,在响应面板直接查看结果。
- 自动清洗和抽取:系统自动处理网页内容,返回可直接用于业务分析、同步和入库的结构化数据。
- 适配动态网页:支持需要 JavaScript 渲染的页面,减少手动处理异步加载内容的工作量。
- 模板化复用:不同业务可以复用同一模板,只需替换输入参数即可执行新的采集任务。
- 结果结构清晰:每个模板提供入参规则和输出 schema,便于确认字段含义并稳定接入后续流程。
Scraping API 适合以下用户和场景:
- 非技术人员需要快速获取网页数据;
- 产品、运营或分析人员进行一次性数据调研;
- 开发团队需要批量创建采集任务,但不希望维护独立爬虫;
- 商品详情、搜索结果等结构化网页数据采集;
- 需要 JavaScript 渲染的动态页面采集;
- 查询任务执行状态并获取采集结果。
2. 使用前准备 #
2.1 获取 API Key #
Scraping API 使用 API Key 进行身份认证。请在账户设置中创建或复制 API Key,并将其安全地保存到服务端环境变量中。
请勿将 API Key 写入前端代码、提交到代码仓库或直接暴露在浏览器页面中。
2.2 准备模板代码 #
每个采集模板都有唯一的 template_code。可以在 Scraping API 页面进入“模板市场”,查看模板详情并确认以下信息:
- 模板代码
template_code; - 模板所需的输入字段;
- 必填字段和字段类型;
- 可选值、最大长度和示例值;
- 返回数据结构;
- 当前单价和结果保留时长。
3. API 地址与认证 #
创建采集任务 #
POST {SCRAPER_API_BASE_URL}/v1/web-scraper/task/create
其中 {SCRAPER_API_BASE_URL} 是项目部署时配置的 Scraping API 服务地址。
请求头:
Authorization: Bearer YOUR_API_KEY
Content-Type: application/json
4. 创建采集任务 #
4.1 请求格式 #
{
    "mode": "sync",
    "template_code": "amazon_product",
    "input": {
        "url": "https://www.example.com/product/123"
    }
}
| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
mode | string | 是 | 任务模式。目前支持 sync 和 async。页面调试默认使用 sync。 |
template_code | string | 是 | 采集模板代码。必须使用模板市场中存在且可用的模板。 |
input | object | 是 | 模板输入参数。字段名称和校验规则以模板详情中的入参规则为准。 |
4.2 同步任务 #
同步任务适合在一次请求中等待采集完成并获取结果的场景:
curl -X POST "{SCRAPER_API_BASE_URL}/v1/web-scraper/task/create" \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer YOUR_API_KEY" \
    -d '{
        "mode": "sync",
        "template_code": "amazon_product",
        "input": {
            "url": "https://www.example.com/product/123"
        }
    }'
4.3 异步任务 #
异步任务适合耗时较长、需要批量提交或不希望阻塞当前请求的场景:
{
    "mode": "async",
    "template_code": "amazon_product",
    "input": {
        "url": "https://www.example.com/product/123"
    }
}
创建成功后请保存返回的 task_id,后续使用任务详情接口查询执行状态。
5. 请求示例 #
Python #
import os

import requests


base_url = os.environ["SCRAPER_API_BASE_URL"]
api_key = os.environ["SCRAPER_API_KEY"]

response = requests.post(
    f"{base_url}/v1/web-scraper/task/create",
    headers={
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json",
    },
    json={
        "mode": "sync",
        "template_code": "amazon_product",
        "input": {
            "url": "https://www.example.com/product/123",
        },
    },
    timeout=120,
)
response.raise_for_status()
print(response.json())
JavaScript #
const response = await fetch(
    `${process.env.SCRAPER_API_BASE_URL}/v1/web-scraper/task/create`,
    {
        method: 'POST',
        headers: {
            Authorization: `Bearer ${process.env.SCRAPER_API_KEY}`,
            'Content-Type': 'application/json',
        },
        body: JSON.stringify({
            mode: 'sync',
            template_code: 'amazon_product',
            input: {
                url: 'https://www.example.com/product/123',
            },
        }),
    },
);

const result = await response.json();
console.log(result);
6. 响应格式 #
所有 Scraping API 响应均使用统一外层结构:
{
    "code": 0,
    "data": {
        "task_id": "task_123",
        "template_code": "amazon_product",
        "mode": "sync",
        "status": "succeeded",
        "result_status": "available",
        "result": {
            "title": "示例商品",
            "price": "19.99"
        },
        "result_url": null,
        "created_at": 1720000000,
        "completed_at": 1720000005,
        "result_expires_at": 1720086400,
        "error": null
    },
    "message": "success"
}
外层字段 #
| 字段 | 类型 | 说明 |
|---|---|---|
code | number | 业务状态码。0 表示请求成功。 |
data | object/null | 请求成功时返回任务或模板数据;失败时可能为 null。 |
message | string | 服务端返回的说明信息。 |
任务字段 #
| 字段 | 类型 | 说明 |
|---|---|---|
task_id | string | 任务唯一 ID。 |
template_code | string | 本次任务使用的模板代码。 |
mode | string | sync 或 async。 |
status | string | queued、running、succeeded 或 failed。 |
result_status | string | not_ready、available、expired 或 unavailable。 |
result | object/array/null | 任务结果。结果结构由模板的输出 schema 决定。 |
result_url | string/null | 结果下载地址。某些任务会通过该地址提供结果。 |
result_expires_at | number/null | 结果过期时间,Unix 时间戳。 |
error | object/null | 失败时的错误信息,包含 code 和 message。 |
7. 查询异步任务 #
GET {SCRAPER_API_BASE_URL}/v1/web-scraper/task/detail?task_id=TASK_ID
Authorization: Bearer YOUR_API_KEY
示例:
curl "{SCRAPER_API_BASE_URL}/v1/web-scraper/task/detail?task_id=task_123" \
    -H "Authorization: Bearer YOUR_API_KEY"
建议根据任务状态处理:
| 状态 | 处理方式 |
|---|---|
queued | 任务已创建,等待执行。 |
running | 任务正在执行,稍后重试查询。 |
succeeded | 任务完成;优先读取 result,必要时再请求 result_url。 |
failed | 读取 error.code 和 error.message,根据错误原因重试或更换模板参数。 |
8. 结果获取与保留 #
当任务返回 result 时,可直接使用该字段;当 result 为空但返回了 result_url 时,请请求该地址获取结果。
结果只在模板详情显示的保留时长内有效。若 result_status 为 expired,需要重新创建任务,不要继续请求已过期的结果地址。
9. 页面端使用流程 #
在 Web 控制台中可以按以下流程使用:
- 打开 Scraping API 页面。
- 在“模板市场”搜索或选择目标站点模板。
- 进入“采集调试”,填写模板要求的入参。
- 在“请求”面板确认生成的
template_code和input。 - 点击“发起请求”,查看“响应”面板中的结果。
- 需要服务端接入时,在请求面板切换 Shell、Python、JavaScript、PHP、Go 或 Java 示例并复制代码。
- 在“任务列表”查看历史任务及结果状态。
页面截图 #
以下截图展示了从选择模板到查看任务和用量的主要页面。截图中的模板、价格、任务记录和统计数据仅用于说明界面,实际内容以当前账户和页面显示为准。
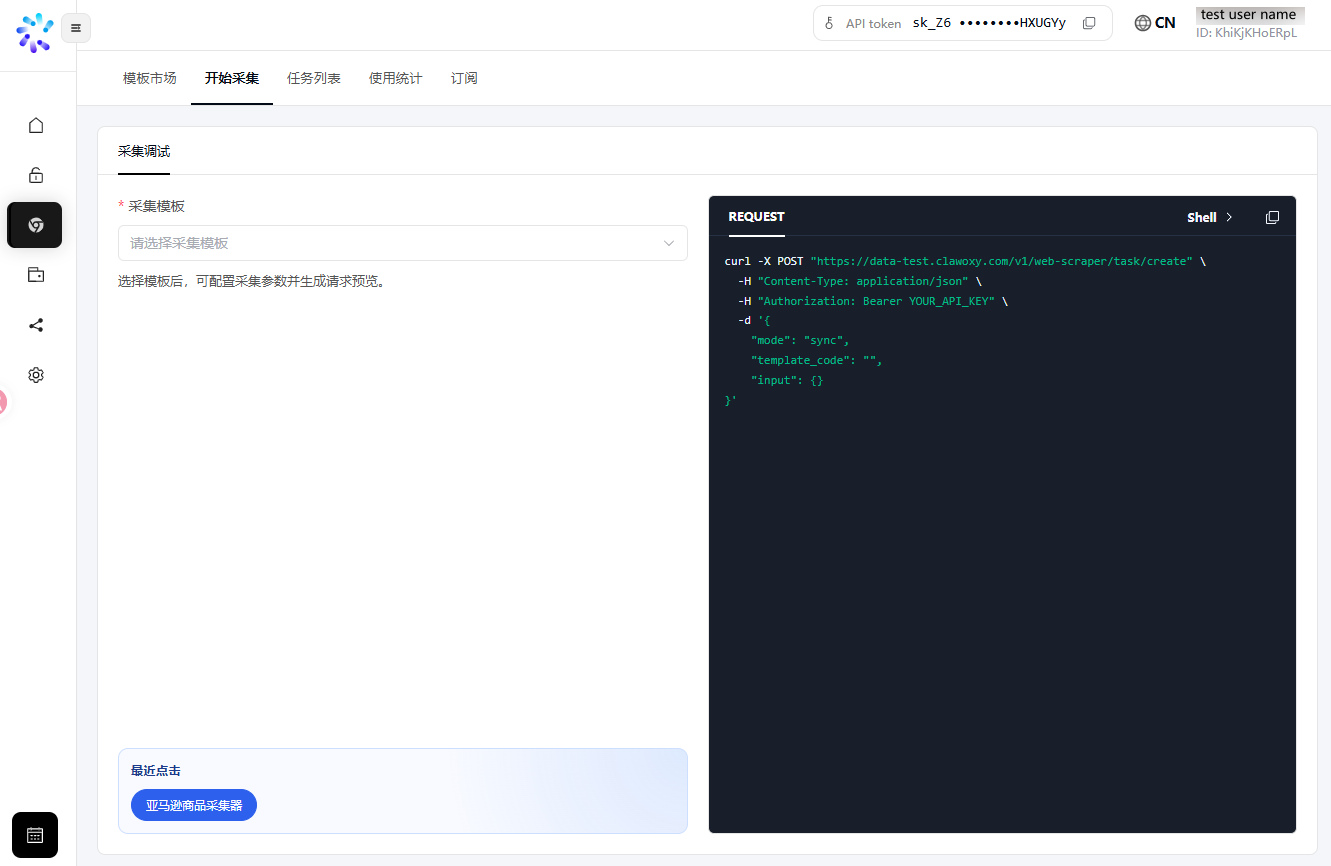
开始采集
进入“开始采集”后,可以选择采集模板;页面右侧会显示根据当前配置生成的请求示例。
模板市场
在模板市场中可以按站点筛选、搜索模板,并查看模板的使用次数和价格信息。
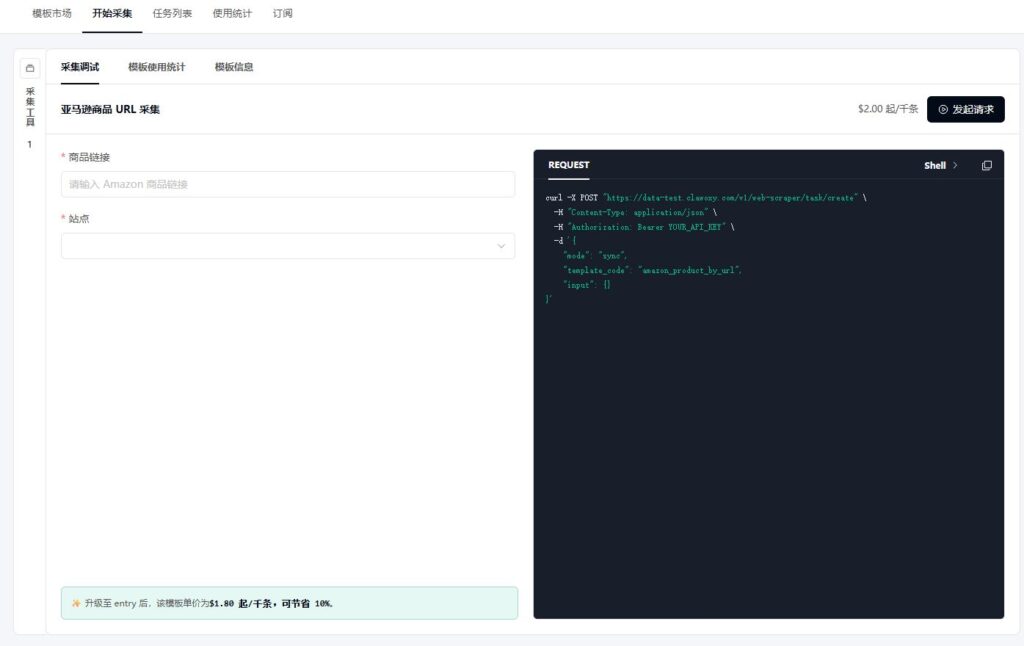
采集调试
选择模板后,在左侧填写模板参数;右侧会同步生成请求预览。确认参数后点击“发起请求”,即可查看采集结果。
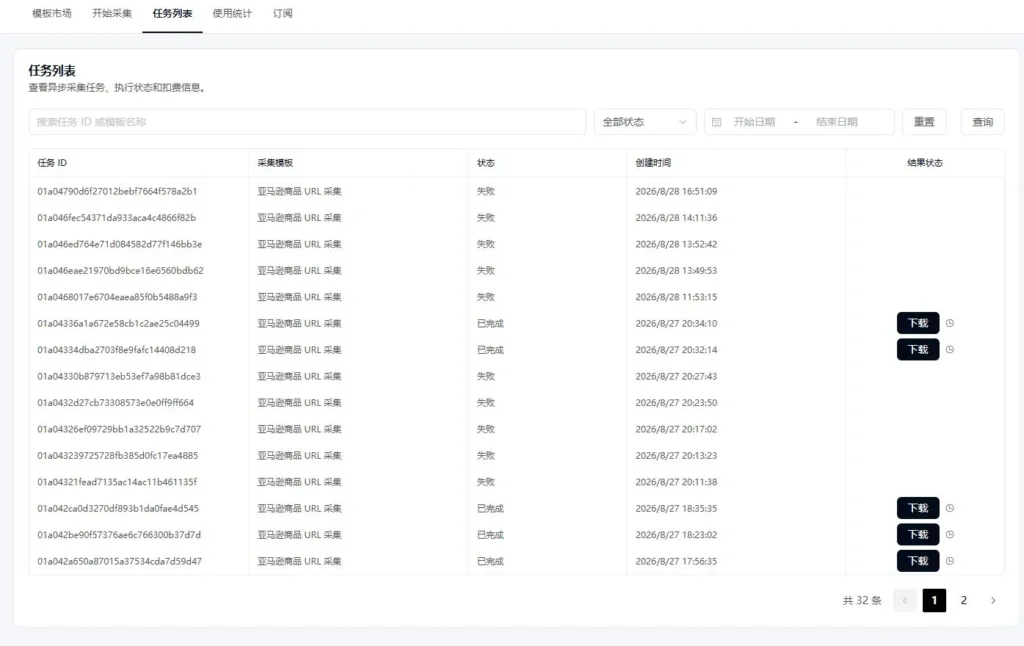
任务列表
任务列表用于查看历史任务的任务 ID、模板、执行状态、创建时间和结果状态。成功任务可以下载结果。
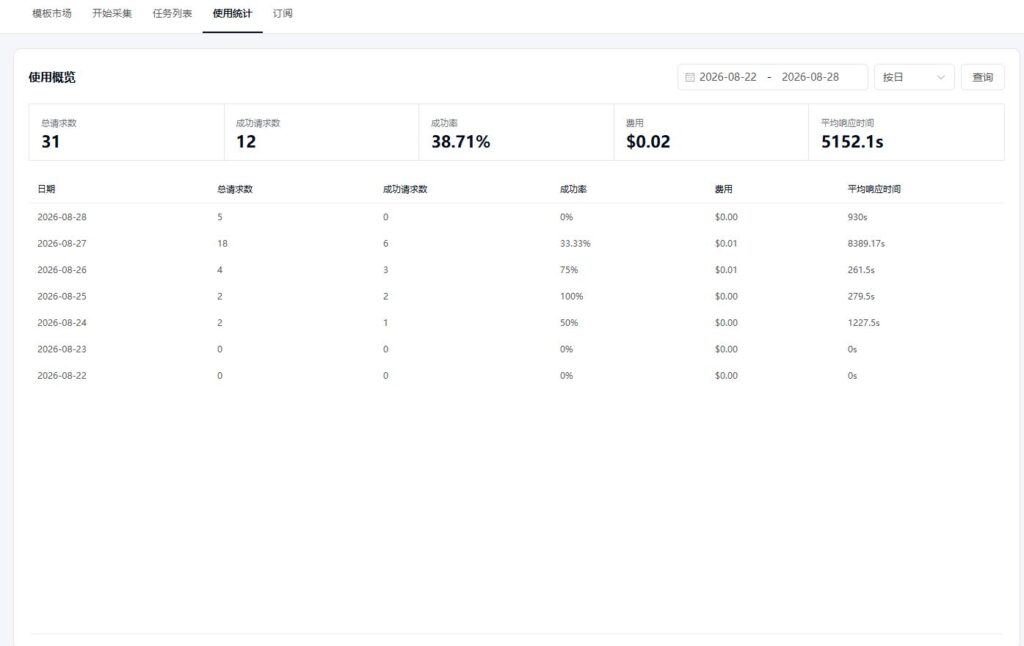
使用统计
使用统计可以按日期范围和统计维度查看请求数、成功数、成功率、费用和平均响应时间。
10. 计费与注意事项 #
- 每个模板的价格可能不同,以模板详情中的当前单价为准。
- 发起请求前请确认账户余额或套餐额度充足。
- 必填字段未填写时,任务不会正常执行;请按照模板入参规则填写。
input中的字段必须使用模板规定的字段名称,不能直接套用其他模板的参数。- API Key 仅应在服务端使用,并建议通过环境变量或密钥管理服务注入。
- 请合理控制轮询频率,异步任务在
queued或running状态时再查询。 - 不要在结果过期后继续使用
result_url;过期后请重新提交任务。


